长上下文能力涉及三个不同的问题:模型能接收多长的输入、能从多远的位置提取信息,以及能以多大的成本持续运行。把上下文窗口从 4K 改成 128K,只改变了配置,还需要位置编码、训练数据和推理系统共同支持。
本文按“问题 → 解决方法 → 主流方案 → 现状”展开:先明确长上下文的瓶颈,再建立方法分类,随后以 YaRN、RoPE base 分析和 StreamingLLM 为代表解释具体机制,最后讨论这些方案已经解决什么、还需要如何评估。文章聚焦已有笔记覆盖的位置扩展与流式推理路线。
问题
先区分三种“长度”
讨论 long context 时,至少需要区分以下三个量:
| 概念 | 回答的问题 | 能说明什么 |
|---|---|---|
| 上下文窗口长度 | 单次请求允许容纳多少 token? | 输入与生成的总预算 |
| 有效上下文长度 | 模型能在多远的位置可靠找到并使用信息? | 与任务、信息位置和干扰程度相关的实际能力 |
| 流式处理总长度 | 模型能连续处理多久而不重置? | 持续运行能力,不代表全部历史仍可访问 |
例如,一个系统可以用固定大小的缓存连续处理数百万 token,却只能直接访问最近一段内容。另一个模型可以接收很长的输入,但仍可能漏掉远处的关键信息。因此,长上下文不能只用一个窗口数字衡量。
位置外推:能计算新位置,不代表能泛化
RoPE 可以为任意位置计算旋转角度,但模型通常只在有限长度的序列上训练。输入超过训练长度后,部分位置关系落到训练分布之外,直接外推可能导致语言建模性能下降。PI 与 YaRN 等方法通过修改位置或频率来缓解这个问题。(Chen et al., 2023; Peng et al., 2023)
位置扩展还面临局部与全局的权衡:如果把所有位置间距一起压缩,远处 token 可以落回较熟悉的范围,但相邻 token 的位置差异也会变小。如何保留局部细节,是不同 RoPE 扩展方法的主要分歧。
资源开销:完整注意力与 KV cache 都会增长
设序列长度为 、注意力头维度为 ,标准完整注意力的核心计算量为 。直接物化注意力矩阵还会产生 的中间存储;FlashAttention 通过分块与优化访存避免完整物化该矩阵,但保留完整注意力的计算语义。(Dao et al., 2022)
自回归推理还有独立的缓存问题。在层数、KV 头数和精度固定时,KV cache 随已处理长度线性增长,单步解码访问的历史也越来越多。限制窗口可以控制成本,却会丢弃历史;StreamingLLM 进一步发现,直接移除初始 token 还可能破坏注意力分布。(Xiao et al., 2024)
训练与评估:长度增加不等于信息利用增加
长窗口需要有意义的长程训练信号。把互不相关的短文档拼接成一个长序列,虽然填满了窗口,却不一定提供跨文档推理或远距离检索的学习机会。已有数据分析也提醒我们,应分别观察文档长度分布和 token 长度分布。(de Vries, 2023)
评估时同样需要区分“语言建模仍然流畅”和“能够利用远处的信息”。RoPE base 分析 中,一些模型的 perplexity 相近,但有效检索范围存在明显差异。这意味着仅看平均 loss,可能高估模型的长上下文能力。
- Chen, S., Wong, S., Chen, L., & Tian, Y. (2023). Extending Context Window of Large Language Models via Positional Interpolation. https://arxiv.org/abs/2306.15595
- Dao, T., Fu, D. Y., Ermon, S., Rudra, A., & Re, C. (2022). FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. In A. H. Oh, A. Agarwal, D. Belgrave, & K. Cho (Eds.), Advances in Neural Information Processing Systems. https://openreview.net/forum?id=H4DqfPSibmx
- de Vries, H. (2023). In the long (context) run. https://www.harmdevries.com/post/context-length/
- Peng, B., Quesnelle, J., Fan, H., & Shippole, E. (2023). YaRN: Efficient Context Window Extension of Large Language Models. https://arxiv.org/abs/2309.00071
- Xiao, G., Tian, Y., Chen, B., Han, S., & Lewis, M. (2024). Efficient Streaming Language Models with Attention Sinks. The Twelfth International Conference on Learning Representations. https://openreview.net/forum?id=NG7sS51zVF
解决方法
从瓶颈到解决方法
长上下文需要同时处理位置表示、资源开销和训练信号。下表先说明方法改变了什么,再进入具体方案。
| 瓶颈 | 解决方法 | 代表方案 | 仍需解决的问题 |
|---|---|---|---|
| 超出训练长度后位置分布发生变化 | 压缩位置坐标或调整 RoPE 频率 | PI、NTK-aware、YaRN | 短文本能力与长距离辨别能力之间的权衡 |
| 远距离相关 token 难以区分 | 调整 RoPE base,并配合长文本训练 | 增大 base 的训练路线 | base 合适也不代表模型已经学会长程依赖 |
| 完整注意力计算和显存开销增长 | 优化注意力的执行与访存 | FlashAttention | 保留完整注意力,计算量仍随长度平方增长 |
| 流式推理的 KV cache 持续增长 | 限制可访问历史并保留初始 token | 滑动窗口、StreamingLLM | 被淘汰的历史无法再被直接访问 |
| 训练样本缺少远距离关联 | 构造连贯的长样本并进行训练 | 长文档、仓库级代码、关联文档 | 样本长度不等于有效依赖长度 |
这些方法可以组合。例如,位置扩展解决可表示的距离,FlashAttention 降低执行开销,长文本训练提供学习信号;是否采用滑动窗口,则取决于任务是否需要完整历史。
理解位置扩展:RoPE、缩放比例与波长
先统一后续方案使用的符号。RoPE 的完整推导参见位置编码,这里使用 来表示RoPE:
其中 是多维旋转矩阵, , , 是一个超参数,RoPE中设置为 , 是对应注意力头的 query/key 投影矩阵(为简化记号,假设输入维度同为 ), 是输入的hidden states.
其中 表示旋转维度, 是 RoPE 的 base; 才是各维度的旋转频率。索引 越小,频率越高、波长越短。后文还会用到两个量:
scaling factor 假设预训练的上下文长度为 , 扩展的上下文长度为 , 则我们定义scaling factor 为
易知 .
wavelength 我们将 定义为 -th 维的RoPE embedding对应的 wavelength:
wavelength 描述了对于第 个二维旋转分量,RoPE旋转一周 () 所需要的上下文长度。
数据与训练:让长窗口包含真实依赖
Harm de Vries 在 2023 年的 In the long (context) run 中抽样分析了预训练数据。以下数字来自当时的数据版本和 tokenizer 设置,描述的是样本统计。(de Vries, 2023)
| 数据来源 | 统计结果 | 统计口径 |
|---|---|---|
| C4 与 RefinedWeb | 超过约 95% 的文档短于 2K token | 文档数占比 |
| RefinedWeb | 约 55% 的 token 来自短于 2K 的文档,约 80% 来自短于 8K 的文档 | token 数占比 |
| RefinedWeb 与 C4 | 来自超过 16K 文档的 token,前者超过 12.5%,后者不到 2.5% | token 数占比 |
| StarCoderData 中各编程语言的源码 | 超过 80% 的文件短于 3K token | 文件数占比 |
| Wikipedia | 超过 50% 的文章长于 4K token | 文章数占比 |
| Gutenberg 书籍 | 超过 75% 的书籍长于 16K token | 书籍数占比 |
短文档数量多,不代表长文档贡献的 token 少;反过来,单个文件很长,也不代表它包含有效的长程依赖。数据筛选需要同时考虑长度与内容关联。
原文提出了几条可探索的数据构造方向:利用网页超链接组织关联文档,利用 repository metadata 组织同一代码库的文件,以及利用跨文件 commit history 组织有演化关系的代码。书籍与长文章也提供了自然连贯的样本。
这些方向的共同目标是让模型有机会学习跨片段关系。对本文讨论的上下文扩展来说,位置编码决定如何表示距离,数据和训练则决定模型是否学会利用这种距离。
- de Vries, H. (2023). In the long (context) run. https://www.harmdevries.com/post/context-length/
主流方案
下面沿两条路线展开:YaRN 与增大 RoPE base 关注更长距离上的位置表示,StreamingLLM 关注有限缓存下的持续推理。三者的目标与评价指标不同,不能仅按宣称的 token 数量排序。
YaRN
YaRN(Yet another RoPE extensioN method)(Peng et al., 2023) 把分频段插值与 attention scaling 结合起来。理解它的设计,可以从 PI 如何压缩位置开始,再看 NTK 系列如何保留局部位置细节。
基于 , 作者统一了已有的扩展上下文长度的方法,作者将不同的扩展方法使用一个通用函数 来表示,这里 和 分别代表了不同的长度外推方法所使用的变换。
Position Interpolation
Position Interpolation (PI) (Chen et al., 2023) 的核心思想在于,我们可以通过Interpolation,将超过预训练长度的文本给压缩到当前最大长度,以此来避免RoPE外推产生的问题,其对应的公式为
其中 为我们扩展之后的上下文长度, 为我们预训练的上下文长度。使用通用函数表示的话,我们有
NTK-aware Interpolation
PI的问题是,并没有考虑不同维度的wavelength。 基于NTK理论,DNN当输入维度比较低,且embedding缺少高频内容时,模型就会很难学习到高频信息。对应到RoPE里面,输入的 token position id 是低维信息(1 维),而输出的RoPE是一个 维的复杂向量。如果统一压缩位置差异,高频细节也会被削弱,从而影响模型区分内容相似、距离很近的 token。
因此,为了解决这个问题,作者对不同的维度使用了不同的缩放策略:高频分量(较小的 )缩放更少,低频分量(较大的 )缩放更多。
基于这个策略,作者提出了NTK-aware interpolation,其定义如下:
其中
这种方法保留了更多高频细节,但部分维度仍会外推到训练范围之外。论文中,不微调时 NTK-aware 优于 PI,而微调后的比较则可能相反;不能脱离训练设置判断两者的优劣。实际使用的缩放比例也可能大于目标长度比例。
上式的推导基于一个简单的假设:我们希望最后一个维度的wavelength在scaling之后,是线性变化的,即 , 求解之后,我们就得到了上面的定义
PI 统一缩放所有频率,NTK-aware 通过修改 base 进行非均匀缩放,但两者都没有显式按照波长与训练长度的关系划分频段。这类不在乎wavelength的方法被称为blind interpolation methods, 接下来要介绍的就是基于wavelength的方法,即target interpolation methods.
NTK-by-parts Interpolation
NTK-by-parts 显式比较波长与训练上下文长度。低频分量的波长较长,在训练窗口内可能尚未旋转一周;高频分量旋转较快,对局部位置差异更敏感。如果把所有频率都压缩,近邻 token 的位置差异也会一起缩小。
因此,作者按频段分配插值强度:
- 波长远小于训练长度的高频分量保持不变,保留局部位置细节。
- 波长接近或超过训练长度的低频分量使用线性插值,避免继续外推。
- 中间频段在两者之间平滑过渡。
作者定义了一个ratio 来描述原始上下文长度 和 wavelength 之间的关系
基于这个ratio,我们可以定义上面的三种处理方式对应的权重
其中, 是超参数, 对应低频分量的线性插值, 对应高频分量保持不变。这里按原始 base 计算波长,与下文实现使用的分段阈值相对应。
最后,NTK-by-parts interpolation的定义如下
作者通过实验发现,在LLaMA上, 和 是一个比较好的选择
Dynamic NTK Interpolation
在实际中,一个经常遇到的场景就是sequence length会从1逐步上升到最大上下文长度,比如说inference的时候。对于这种情况,我们有两种解决方法:
- 在整个inference周期中,RoPE的scaling factor都设置为 , 其中 是扩展后的上下文长度
- 在每次forward 的过程中,都更新scaling factor , 这里 是当前sequence的长度
作者发现,方案1在sequence长度小于 的时候性能会下降,并且当上下文长度超过 时,性能下降的更快。 但是,方案2可以让模型的性能下降曲线更平缓。因此,作者将这种inference-time方法称为 Dynamic Scaling method, 当其与NTK-aware方法结合时,就得到了 Dynamic NTK interpolation
论文也考察了未经长上下文微调的模型。实现动态缩放时,需要保持历史 key 与当前 query 的 RoPE 缩放一致,不能只更新新 token 的频率而沿用旧缩放下的 KV cache。
Attention scaling:组成完整的 YaRN
在 NTK-by-parts 的基础上,YaRN 还在计算attention softmax时,加入了一个温度参数 , 这样attention的计算就变成了
作者发现,通过这种scaling的方式,YaRN可以在不改变代码的前提下,更改attention的机制。这种常数缩放可以并入 RoPE 的计算;但扩展序列本身仍会增加训练和推理成本
作者将YaRN定义为结合了NTK-by-parts interpolation和上述scaling技巧的方法
对于LLaMA,作者推荐使用如下参数:
实验结果如下
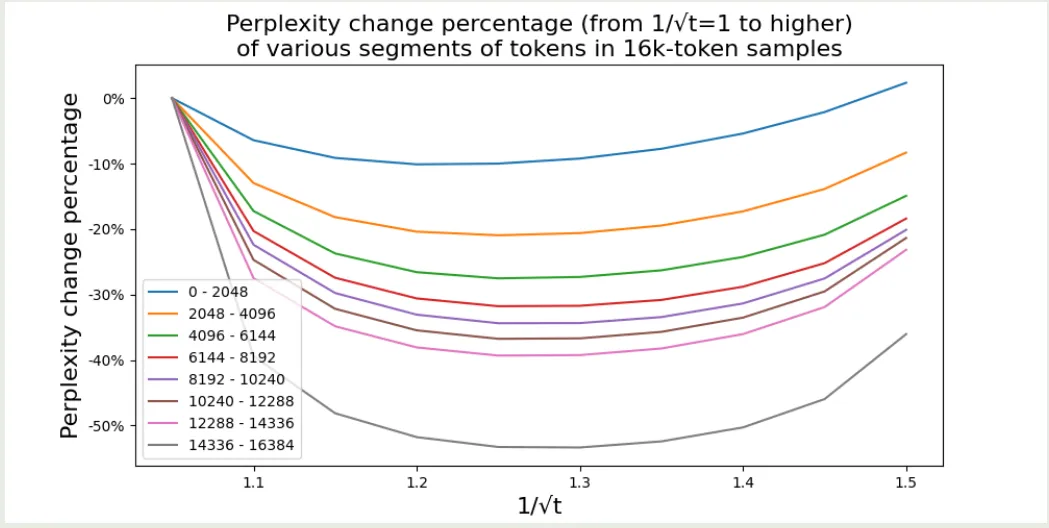
作者发现:
- 选择合适的 可以改善扩展窗口后的 perplexity
- 温度缩放在所评估的不同位置和样本上呈现较一致的收益
YaRN 的实验结果
实验结果如下
下表给出不同评估长度上的 perplexity(越低越好),保留原论文对比设置:
| 方法 | 训练 token 数 | 训练窗口 | 评估 2048 | 评估 4096 | 评估 6144 | 评估 8192 | 评估 10240 |
|---|---|---|---|---|---|---|---|
| PI(s = 2) | 1B | 8k | 3.92 | 3.51 | 3.51 | 3.34 | 8.07 |
| NTK( = 20k) | 1B | 8k | 4.20 | 3.75 | 3.74 | 3.59 | 6.24 |
| YaRN(s = 2) | 400M | 8k | 3.91 | 3.50 | 3.51 | 3.35 | 6.04 |
可以看到,YaRN使用的数据更少,并且当模型扩展到10240的时候,其表现下降的最慢,这说明了YaRN在扩展上下文长度时的有效性
原始RoPE,dynamic-PI和dynamic-YaRN的对比
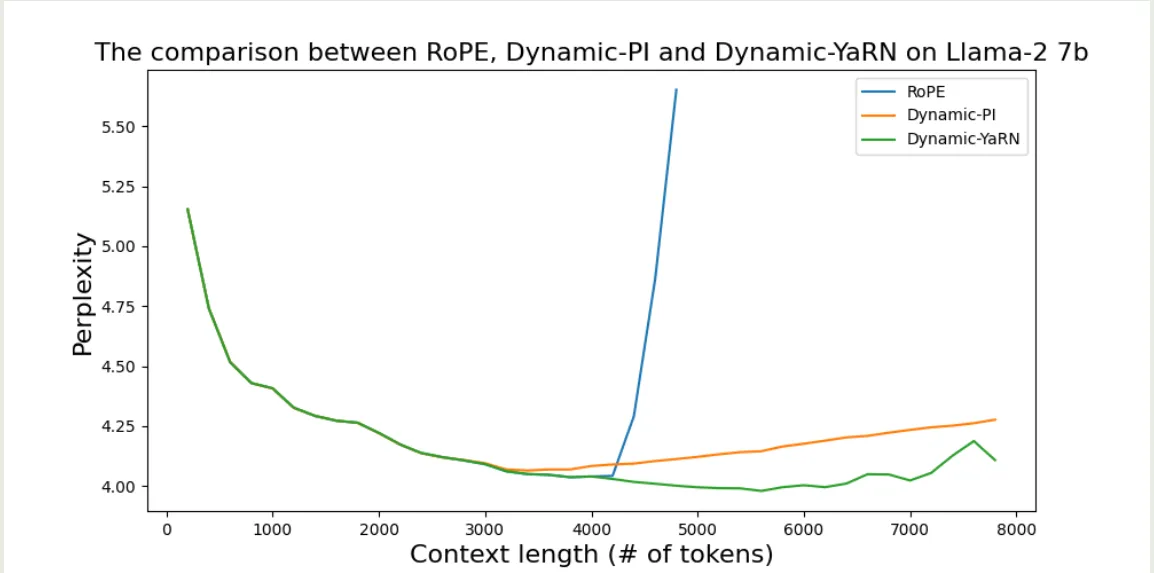
在这组 perplexity 实验中,直接使用原始 RoPE 的外推能力较差,Dynamic-YaRN 的曲线更稳定。该结果反映特定模型与数据上的语言建模表现,不能单独证明所有长文本任务都得到改善。
YaRN 的实现与配置
以 Transformers v4.51.3 为例,YaRN 的实现在HuggingFace/src/transformers/modeling_rope_utils.py 里的 _compute_yarn_parameters 函数里,其返回 inv_freq 以及 attention_factor 两个量,前者代表了 , 后者是作用于 RoPE 的幅度系数 ;同时缩放 query 和 key 后,attention logits 会乘以 。下面保留计算频率与幅度的简化示意,不是完整的模型层实现。
import math
import torch

def get_mscale(scale):
    if scale <= 1:
        return 1.0
    return 0.1 * math.log(scale) + 1.0

def find_correction_dim(num_rotations, dim, base, max_position_embeddings):
    """Inverse dimension formula to find the dimension based on the number of rotations"""
    return (dim * math.log(max_position_embeddings / (num_rotations * 2 * math.pi))) / (2 * math.log(base))

def find_correction_range(low_rot, high_rot, dim, base, max_position_embeddings):
    """Find dimension range bounds based on rotations"""
    low = math.floor(find_correction_dim(low_rot, dim, base, max_position_embeddings))
    high = math.ceil(find_correction_dim(high_rot, dim, base, max_position_embeddings))
    return max(low, 0), min(high, dim - 1)

def linear_ramp_factor(min, max, dim):
    if min == max:
        max += 0.001  # Prevent singularity

    linear_func = (torch.arange(dim, dtype=torch.float32) - min) / (max - min)
    ramp_func = torch.clamp(linear_func, 0, 1)
    return ramp_func


def yarn_parameters(dim, base, factor, original_max_position_embeddings,
                    beta_fast=32, beta_slow=1):
    pos_freqs = base ** (torch.arange(0, dim, 2) / dim)
    inv_freq_extrapolation = 1.0 / pos_freqs
    inv_freq_interpolation = 1.0 / (factor * pos_freqs)

    low, high = find_correction_range(
        beta_fast, beta_slow, dim, base, original_max_position_embeddings
    )
    extrapolation_weight = 1 - linear_ramp_factor(low, high, dim // 2)
    inv_freq = (
        inv_freq_interpolation * (1 - extrapolation_weight)
        + inv_freq_extrapolation * extrapolation_weight
    )
    attention_factor = get_mscale(factor)
    return inv_freq, attention_factor
实际模型如何配置缩放比例,见最后一节的 Qwen3-8B 示例。
延伸阅读
- Chen, S., Wong, S., Chen, L., & Tian, Y. (2023). Extending Context Window of Large Language Models via Positional Interpolation. https://arxiv.org/abs/2306.15595
- Peng, B., Quesnelle, J., Fan, H., & Shippole, E. (2023). YaRN: Efficient Context Window Extension of Large Language Models. https://arxiv.org/abs/2309.00071
RoPE base:增大基数与长距离辨别能力
增大 RoPE base 是上下文扩展的一条路线,ABF(Adjusted Base Frequency)(Xiong et al., 2024) 是相关工作之一。本节的理论和实验来自另一篇论文 Base of RoPE Bounds Context Length,需要区分这两个来源。
这篇论文研究 RoPE base 与有效上下文长度的关系,并在给定假设下估计目标长度所需的 base 下界。它为“模型是否真正利用远处内容”提供了补充分析视角。
从注意力分数到相关 token 的辨别能力
首先作者回顾了 attention 与 RoPE 的定义, 关键就是 RoPE 这部分,如下所示
这里 就是 base frequency, 论文记录的部分模型配置如下;这是论文发表时的具体模型版本,不能作为同名系列后续版本的配置表
| Model | Llama-7B | Llama2-7B | Llama3-8B | Mistral-7B | Baichuan2-7B |
|---|---|---|---|---|---|
| Base frequency | 10,000 | 10,000 | 500,000 | 1,000,000 | 10,000 |
| Context length | 2048 | 4096 | 8192 | 32,768 | 4,096 |
前面的 YaRN 通过调整频率减轻位置外推问题。这里进一步追问:即使位置分布得到控制,模型是否仍能在远距离区分相关 token 与无关 token?
作者认为 base frequency 的设置应该满足两个条件:
- The closer token gets more attention: 当前的 token 应该给邻近的 token 更高的注意力
- The similar token gets more attention: 当前的 token 应该给相似的 token 更高的注意力
在 RoPE 中,作者已经给出了 与相对距离 之间的关系。这种衰减描述的是理论上的趋势,并不保证每一对实际 token 的注意力都随距离单调下降。
接下来,作者分析了相似 token 的性质,作者定义 token 的相似性如下:
这里 代表了相似的 token, 而 是一个随机 token. 作者给出的结论如下
Theorem 假设 的分量独立同分布,标准差为 ,且随机 key 与 query 独立;令 ,噪声与 独立且 , 则我们有
作者定义 , 作者认为给定 , 模型的上下文长度 满足
在上述假设下,base 会限制相关 token 保持期望分数优势的距离。下表是论文设置下的数值估计,依赖旋转维度与分析假设,不能直接当作所有模型的通用配置要求
| Context Len. | 1k | 2k | 4k | 8k | 16k | 32k | 64k | 128k | 256k | 512k | 1M |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Lower Bound | 4.3e3 | 1.6e4 | 2.7e4 | 8.4e4 | 3.1e5 | 6.4e5 | 2.1e6 | 7.8e6 | 3.6e7 | 6.4e7 | 5.1e8 |
这里需要同时关注两种性质:对邻近位置的偏好,以及在远距离上保持相关 token 相对于随机 token 的分数优势。二者都是分析视角,不能单独保证下游任务的准确率。
Base 的实验结果
作者首先分析了 base frequency 在 fine-tuning 阶段对模型上下文能力的影响,实验结果如下图所示
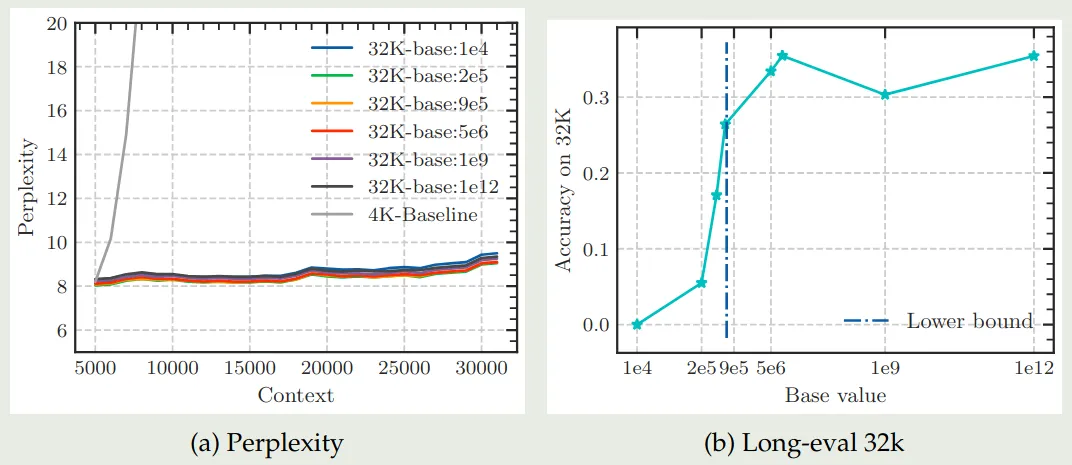
从实验结果可以看到,当 base frequency 低于阈值时,模型的表现急剧下降。
作者进一步探讨了 base frequency 对于模型 pre-training 阶段的影响,结果也是一样的,即非常小的 base frequency 会限制模型的 context 能力,结果下图所示 (第一行是 base 为 1e2 的预训练模型,第二、三行分别是在更长序列上以 1e4、1e6 继续微调的结果)
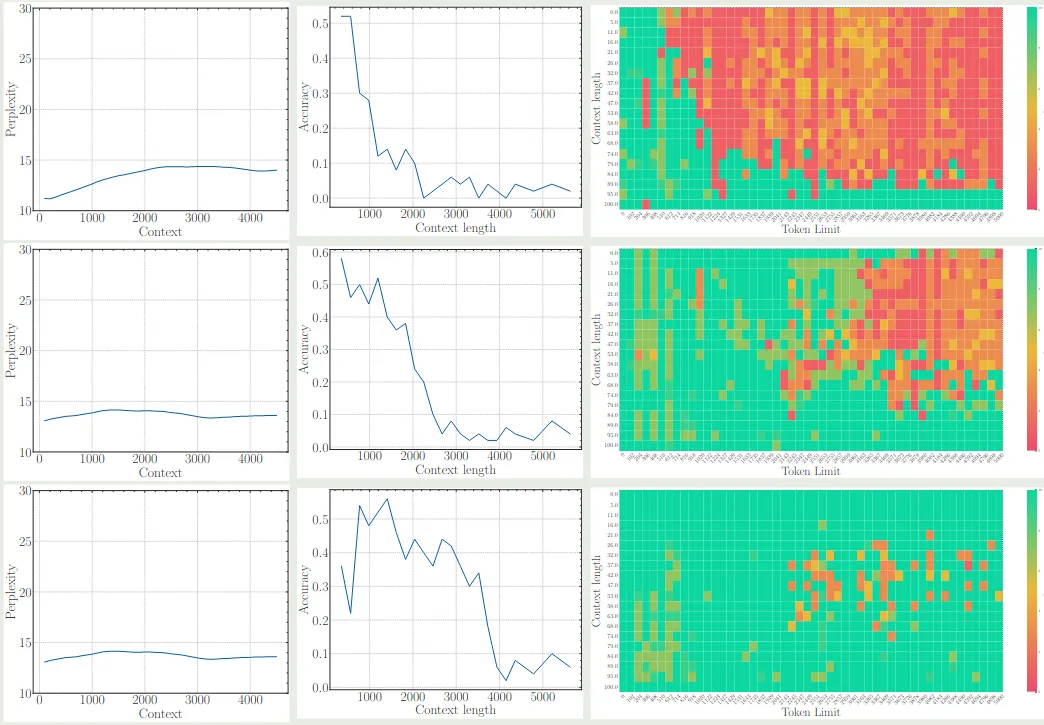
可以看到,尽管 perplexity 都差不多,但是使用更大的 base frequency 其长上下文能力明显更好。
作者进一步分析了为什么较小的 base frequency 会影响模型的长上下文能力。作者认为较小的 base frequency 会导致 接近于 0, 从而模型难以区分随机 token 和相似 token, 这样模型只能依赖于邻近 token 进行学习,这样就限制了模型的长上下文能力
作者还进一步对比了提高 base frequency 与 Interpolation 两种做法,实验结果如下表所示
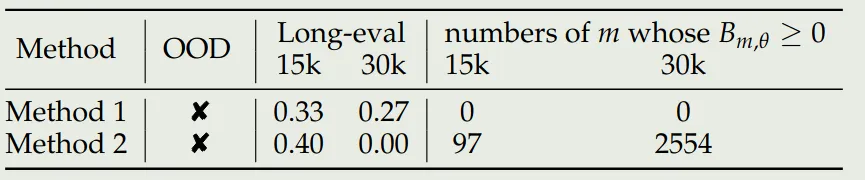
实验结果说明,Interpolation 在上下文超过 30K 之后,其 的 次数显著增加,表明了其和上下文能力之间的关系。
Base 分析的适用边界
这项工作的启发是:位置分布是否越界与远距离信息是否可辨别,需要分别检查。论文也指出,多层网络可能提取超过单层分析范围的信息,因此这个 lower bound 不是完整 LLM 的严格能力上限。增大 base 应与训练长度、数据和检索评估一起考虑。
延伸阅读
- Xiong, W., Liu, J., Molybog, I., Zhang, H., Bhargava, P., Hou, R., Martin, L., Rungta, R., Sankararaman, K. A., Oguz, B., Khabsa, M., Fang, H., Mehdad, Y., Narang, S., Malik, K., Fan, A., Bhosale, S., Edunov, S., Lewis, M., … Ma, H. (2024). Effective Long-Context Scaling of Foundation Models. In K. Duh, H. Gomez, & S. Bethard (Eds.), Proceedings of the 2024 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies (Volume 1: Long Papers) (pp. 4643–4663). Association for Computational Linguistics. 10.18653/v1/2024.naacl-long.260
StreamingLLM:固定缓存下的持续推理
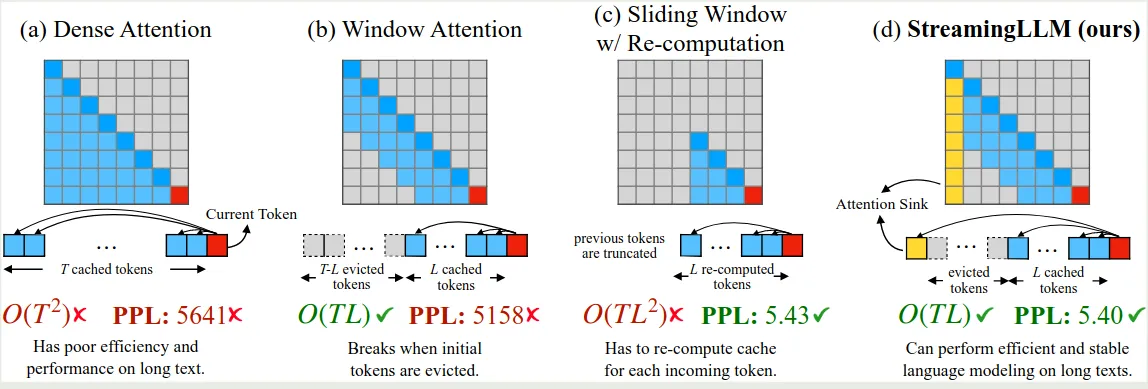
StreamingLLM (Xiao et al., 2024) 处理的是流式推理中的缓存问题:当输入持续到来,如何在固定大小的 KV cache 下保持语言建模稳定?它保留少量初始 token 作为 attention sink,同时缓存最近的 token。
这里需要区分两个目标:YaRN 等方案扩展一次注意力计算可利用的位置范围;StreamingLLM 则通过淘汰历史来控制成本。持续运行的总长度可以很长,但模型只能直接访问保留下来的历史。
Attention sink:为什么只保留滑动窗口还不够
作者首先探究了一下 softmax attention 以及 sliding window attention 性能下降的节点,实验结果如下图所示
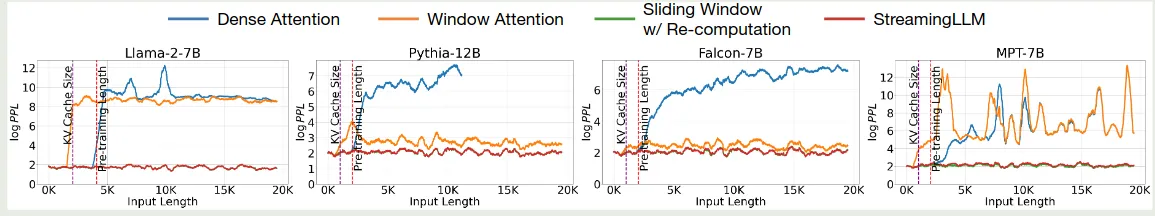
可以看到,softmax attention 性能急剧下降的节点为 pre-training 的 context length; 而 sliding window attention 性能急剧下降的节点为 KV cache size.
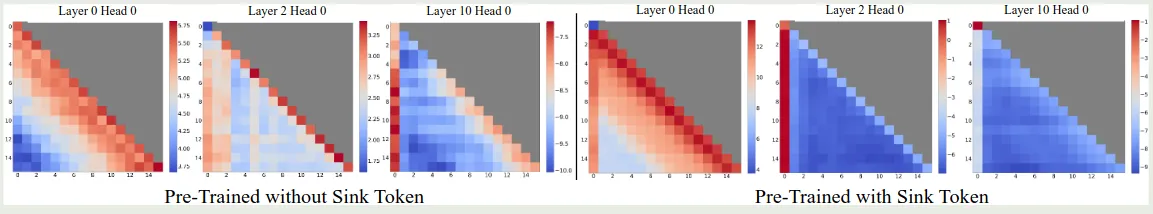
接下来,作者分析了一下不同 layer 的 attention 分布情况,如下图所示
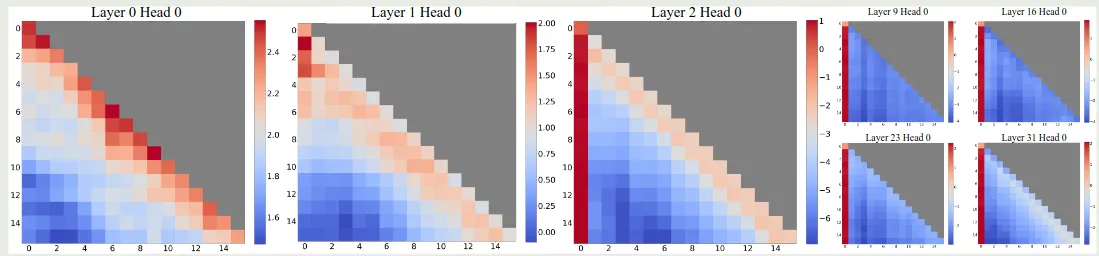
可以看到,初始的 2 层 layer 里 attention logits 的分布比较均匀。但是在后续的 layer 里,第一个 token 的权重都大幅度上升。
作者分析原因认为,sliding window attention 在超过 KV cache size 之后性能急剧下降的主要原因是初始 token 不再参与 softmax 的计算,这导致了 softmax 的计算出现了比较大的变化,从而模型的表现开始下降。
为了探究初始 token 对最终模型表现的影响因素是语义层面还是位置层面的,作者将初始的 token 替换为 \n, 并比较了模型的表现,结果如下表所示
| Llama-2-13B | PPL (↓) |
|---|---|
| 0 + 1024(Window) | 5158.07 |
| 4 + 1020 | 5.40 |
| 4”\n”+1020 | 5.60 |
可以看到,把初始的四个 token 替换为 \n, 并不影响模型最终的表现,这说明是初始 token 的位置信息在发挥作用。
作者接下来探究了一下模型架构的影响,实验结果如下表所示
| Cache Config | 0+2048 | 1+2047 | 2+2046 | 4+2044 | 8+2040 |
|---|---|---|---|---|---|
| Falcon-7B | 17.90 | 12.12 | 12.12 | 12.12 | 12.12 |
| MPT-7B | 460.29 | 14.99 | 15.00 | 14.99 | 14.98 |
| Pythia-12B | 21.62 | 11.95 | 12.09 | 12.09 | 12.02 |
| Cache Config | 0+4096 | 1+4095 | 2+4094 | 4+4092 | 8+4088 |
| Llama-2-7B | 3359.95 | 11.88 | 10.51 | 9.59 | 9.54 |
可以看到,不同的模型架构都存在这个问题,说明这个现象出现在论文评估的多种架构上。在这些实验中,保留 4 个初始 token 已能恢复大部分性能,继续增加数量的收益较小。
作者把这个现象与 softmax 归一化联系起来:注意力权重之和必须为 1,即使当前 query 不需要从历史中提取很多信息,也需要给某些位置分配权重。因果注意力中的初始 token 对后续位置一直可见,容易成为这样的 sink;高注意力权重不必意味着语义重要。
保留初始 token 与最近窗口
为了解决这个问题,作者就提出了缓存初始 token 的方法,具体做法就是,在 sliding window attention 的基础上,我们还会加上初始 token 的信息,作者展示示意图如下所示
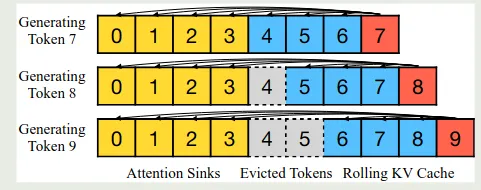
设初始 token 数量为 ,最近窗口大小为 ,每一步最多缓存 个 token 的 KV。图中的 4 个初始 token 与 3 个最近 token 是示意配置,实际窗口应按任务设置。处理新 token 时保留初始部分、淘汰最近窗口中最旧的部分,并按缓存内的相对位置处理 RoPE,避免位置编号随流长度无限增大。
作者对比了不同 attention 的计算方式:
训练阶段的 learnable sink
前面是在 inference 阶段进行优化的,作者现在进一步探究在 pre-training 阶段加入 attention sink 参与训练对模型表现的影响。
softmax-off-by-one 提出了我们应该加入一个 zero sink token, 其计算公式如下
这里 是输入的序列。我们可以将 sink token 视为一个 key 以及 value 都是 0 向量的特殊 token.
在本文中,作者使用了一个可学习的 sink token. 作者对比了原始 softmax attention, 使用 zero sink attention, learnable sink attention 三种方法的表现,结果如下表所示
| Cache Config | 0+1024 | 1+1023 | 2+1022 | 4+1020 |
|---|---|---|---|---|
| Vanilla | 27.87 | 18.49 | 18.05 | 18.05 |
| Zero Sink | 29214 | 19.90 | 18.27 | 18.01 |
| Learnable Sink | 1235 | 18.01 | 18.01 | 18.02 |
可以看到 zero sink 仍然需要一部分初始 token 来维持模型的表现。作者在论文中推荐使用 learnable sink.
StreamingLLM 的实验结果
作者首先验证了 StreamingLLM 在不同架构上的表现,结果如下图所示
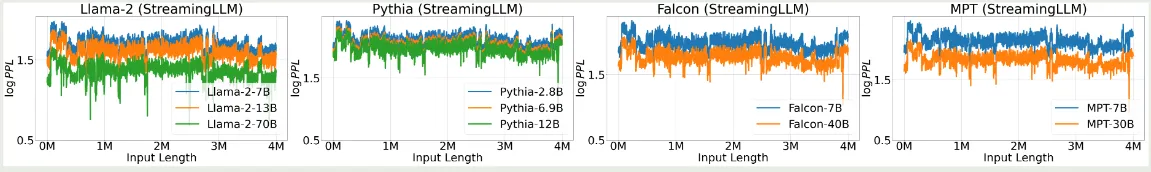
实验结果显示,StreamingLLM 能在总长度达到 4M token 的流上维持稳定的语言建模表现。这里的 4M 是累计处理长度,不是可同时检索的上下文窗口。
接下来,作者探究了在 Pretraining 阶段加入 learnable sink token 对模型表现的影响,结果如下图所示
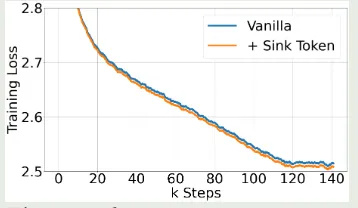
可以看到,加入 sink token 之后对模型的表现没有显著影响。并且,模型在下游任务上的表现与标准的 softmax attention 表现差不多。
作者还对 StreamingLLM 进行了可视化,结果如下图所示
作者进一步评估了 StreamingLLM 在下游任务上的表现,我们主要关注一下 ARC 上的表现,结果如下图所示
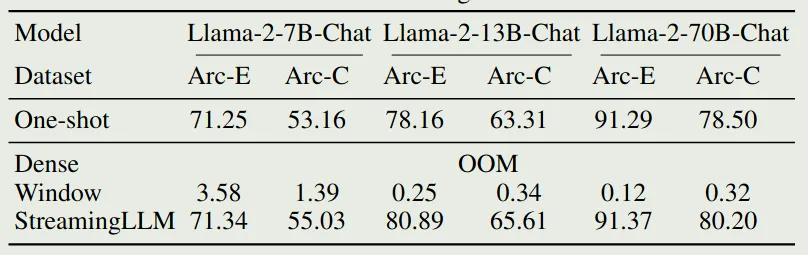
可以看到,full attention 出现了 OOM error, 而 sliding window attention 虽然避免了 OOM 的问题,但是其表现非常差。而 StreamingLLM 则进一步提高了 Sliding Window attention 的表现。
StreamingLLM 的适用边界
StreamingLLM 适合主要依赖近期内容、需要持续运行的任务。它不保留已淘汰历史的完整信息,因此不能据此声称模型具备无限长记忆。需要跨整本书检索或总结时,仍然要解决历史信息如何保留和访问的问题。参见项目 FAQ。
延伸阅读
- Xiao, G., Tian, Y., Chen, B., Han, S., & Lewis, M. (2024). Efficient Streaming Language Models with Attention Sinks. The Twelfth International Conference on Learning Representations. https://openreview.net/forum?id=NG7sS51zVF
现状
已有进展:位置扩展与流式推理各有适用范围
结合前面的论文与实现,可以将本文覆盖路线的进展归纳如下。这里讨论的是代表方案的落地情况与能力边界,原论文的实验数字仍对应各自发表时的模型和设置。
| 路线 | 已有进展 | 能力边界 |
|---|---|---|
| PI、NTK 系列与 YaRN | 形成了修改位置坐标、频率和 attention scaling 的扩展方法 | 扩展比例、训练方式及短文本性能需要一起验证 |
| RoPE base 分析 | 将远距离相关 token 的辨别能力纳入位置编码分析 | 理论约束依赖假设,不能代替完整模型评估 |
| FlashAttention | 改善完整注意力的执行效率与中间存储开销 | 不自动赋予长度外推能力,也不消除平方级计算量 |
| StreamingLLM | 在固定缓存预算下稳定处理很长的输入流 | 累计处理长度不等于可访问历史长度 |
| 长文本数据构造 | 可以通过自然长文档与关联元数据提供更连贯的训练样本 | 仍要检查任务是否真正要求远距离信息 |
从这些结果可以得到一个实践判断:窗口扩展、运行效率和信息利用率需要分别验证。前面的方案可以互补,但不能互相替代。
落地示例:Qwen3-8B 的 YaRN 配置
以本文原有的 Qwen3-8B 为例,官方模型卡 给出的原生上下文长度为 32,768 token,并说明使用 YaRN 验证到了 131,072 token。这个数字包括输入与输出,且只对应这一具体模型。
下面沿用模型卡的 rope_scaling 配置方式,在加载模型时传入扩展参数:
from transformers import pipeline

generator = pipeline(
    "text-generation",
    "Qwen/Qwen3-8B",
    torch_dtype="auto",
    device_map="auto",
    model_kwargs={
        "max_position_embeddings": 131072,
        "rope_scaling": {
            "rope_type": "yarn",
            "factor": 4.0,
            "original_max_position_embeddings": 32768,
        },
    },
)
配置窗口上限不等于显存足以运行该长度,还需要确认框架支持、KV cache 预算以及生成长度。Qwen 的 vLLM 文档 也提醒:静态 YaRN 在短输入上仍使用固定缩放,可能影响短文本性能,应按实际所需长度设置扩展比例。不要仅为了更大的窗口数字而启用更强的缩放。
尚未解决:可靠利用远距离信息
原文涉及的实验已经说明,低 perplexity、大窗口和长时间流式运行衡量的是不同能力。下一步评估应围绕实际任务展开,而不是只确认模型能否接受输入。
| 评估维度 | 应观察的结果 |
|---|---|
| 长度与位置 | 将关键信息放在开头、中间、末尾,并逐步增加距离,观察检索准确率 |
| 信息组合 | 检查是否能整合多个远处分散的事实,而不仅是找回单个 passkey |
| 干扰与相关性 | 增加相似但无关的内容,检查模型能否保持辨别能力 |
| 短文本能力 | 在扩展配置下复测原有短上下文任务,确认是否出现退化 |
| 推理成本 | 分别记录 prefill、单步 decoding 延迟和峰值显存 |
| 历史淘汰 | 对滑动窗口方案检查哪些事实会随缓存淘汰而丢失 |
因此,实际选型可以从信息访问需求出发:需要跨完整输入查找证据时,重点验证有效上下文长度;主要依赖近期内容且必须持续运行时,重点验证窗口缓存策略。两类任务都应结合长程数据和任务指标判断效果。