统一记号与计算口径
评估一个 LLM 的资源需求,需要分别回答三个问题:模型有多少参数、一次训练或推理需要多少计算、运行时需要多少显存。三者相关,但不能互相替代:MoE 的总参数量决定权重存储规模,激活专家数影响计算量;上下文变长不会增加参数,却会增加 attention 计算和 KV cache。
本文以 Qwen3 的 decoder-only Transformer 为例,依次推导参数量、FLOPs、训练与推理显存,最后讨论优化方法及其代价。
| 变量 | 配置或含义 |
|---|---|
| / | 总参数量 / 每个 token 的激活参数量 |
Transformer 层数,num_hidden_layers | |
词表大小,vocab_size | |
隐藏维度,hidden_size | |
Dense FFN 的 intermediate_size;MoE 专家的 moe_intermediate_size | |
| / | Query / KV head 数 |
每个 head 的维度,head_dim | |
| / | 专家总数 / 每个 token 激活的专家数 |
| / | 序列长度 / 单卡 micro-batch size;推理时 为并发序列数 |
| / | 训练 token 总数 / 总 FLOPs |
- 参数量按独立存储的权重元素计数;共享 embedding 只计算一次。除特别说明外,使用无 bias 的投影和 SwiGLU FFN。
- FLOPs 表示浮点运算次数,FLOP/s 表示运算速率。一次乘加按 2 FLOPs 计算,主要统计矩阵乘法。单序列公式取 ,batch 计算量再乘 。
- 显存公式以 bytes 为单位,默认权重和 KV cache 使用 BF16/FP16,每个元素 2 bytes。优化器状态、主权重和梯度精度单独说明。
- 不默认 ;只有简化为标准 MHA 时才使用这一关系。没有特别说明的显存推导不包含分片、offloading、allocator 保留空间和通信 buffer。
参数量计算
参数量描述需要存储的权重规模,也是后续估计算力和显存的起点。先计算 Dense 模型,再把 FFN 替换为 MoE。
Dense Model
我们首先来看一下 Qwen3 的架构,如下图所示
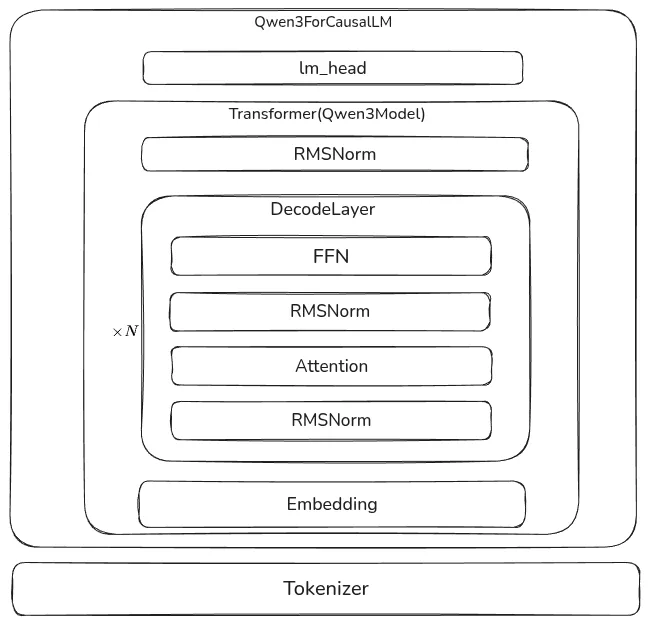
这里,Qwen3ForCausalLM 就是我们的 LLM, 其关键代码如下
class Qwen3ForCausalLM:
    def __init__(self, config):
        self.model = Qwen3Model(config)
        self.lm_head = nn.Linear(config.hidden_size, config.vocab_size, bias=False)
我们假设 vocab_size, 也就是词表大小为 (我们用 表示词表), hidden_size 为 , 则总参数量为
Qwen3Model 包含三个(含参数的)模块,分别是 nn.Embedding, Qwen3DecodeLayer 以及 Qwen3RMSNorm, 分别代表了输入 token 的 embedding layer, Transformer block 和对输出的 normalization. 其关键代码如下:
class Qwen3Model:
    def __init__(self, config: Qwen3Config):
        self.embed_tokens = nn.Embedding(config.vocab_size, config.hidden_size, self.padding_idx)
        self.layers = nn.ModuleList(
            [Qwen3DecoderLayer(config, layer_idx) for layer_idx in range(config.num_hidden_layers)]
        )
        self.norm = Qwen3RMSNorm(config.hidden_size, eps=config.rms_norm_eps)
其中,nn.Embedding 参数量与 lm_head 一样,都是 .
对于 normalization, 现在大部分 LLM 用的都是 RMSNorm, 其定义如下:
其参数量为:。对每个 head 使用 QK-Norm 时,将这里的维度替换为 。
如果说我们使用的是 LayerNorm, 则其定义如下:
其参数量为: .
因此,Qwen3Model 的参数量为
这里第一项为 nn.Embedding, 第三项为 Qwen3RMSNorm, 第二项里, 代表 decode layer 的个数,也就是 config.num_hidden_layers.
Qwen3DecoderLayer 包含了四个模块,其关键代码如下
class Qwen3DecoderLayer:
    def __init__(self, config: Qwen3Config):
        self.self_attn = Qwen3Attention(config=config, layer_idx=layer_idx)
        self.mlp = Qwen3MLP(config)
        self.input_layernorm = Qwen3RMSNorm(config.hidden_size, eps=config.rms_norm_eps)
        self.post_attention_layernorm = Qwen3RMSNorm(config.hidden_size, eps=config.rms_norm_eps)
因此,Qwen3DecoderLayer 的参数量为
其中,第一项是两个 Qwen3RMSNorm 的参数。
对于 Qwen3MLP, 其定义如下:
这里 , , 是 MLP 的 hidden size, 代码中用 intermediate_size 来表示,因此
这里三项分别代表 的参数量。
如果说,我们使用原始 transformer 的 MLP, 也就是
其中 , , , , 则总参数为
这里的四项分别代表了 .
Qwen3Attention
接下来,就是 Attention 部分的参数,Qwen3Attention 的关键代码如下:
class Qwen3Attention:
    def __init__(self, config: Qwen3Config, layer_idx: int):
        self.q_proj = nn.Linear(
            config.hidden_size, config.num_attention_heads * self.head_dim, bias=config.attention_bias
        )
        self.k_proj = nn.Linear(config.hidden_size, config.num_key_value_heads * self.head_dim, bias=config.attention_bias)
        self.v_proj = nn.Linear(config.hidden_size, config.num_key_value_heads * self.head_dim, bias=config.attention_bias)
        self.o_proj = nn.Linear(config.num_attention_heads * self.head_dim, config.hidden_size, bias=config.attention_bias)
        self.q_norm = Qwen3RMSNorm(self.head_dim, eps=config.rms_norm_eps)
        self.k_norm = Qwen3RMSNorm(self.head_dim, eps=config.rms_norm_eps)
这里,我们先定义几个量:
- 我们将 head 的个数记为 , 即
num_attention_heads - 我们将每个 head 的 hidden size 记为 , 即
head_dim - 我们将 key 和 value head 的个数记为 , 即
num_key_value_heads
Qwen3Attention 的参数由以下几个部分组成:
- Query projection: ,
- Key projection: ,
- Value projection: ,
- output projection:
- RMSNorm:前文已经提到过,两个 normalization (query norm 以及 key norm) 的总参数量为 .
因此, Qwen3Attention 部分的总参数量为
分别代表 和 两个 normalization layer 的参数量。
注意,这里我们没有加入 bias, 这是因为 QKV bias 在 Qwen3 中被取消,取而代之的是两个 normalization.
如果我们查看 Qwen2Attention 的代码,我们可以得到 Qwen2Attention 的总参数量为
分别代表 和 的参数量。
我们将计算结果汇总在一起就得到:
以上即未共享 embedding 时的总参数量 。
Verification
接下来,我们就可以基于 Qwen3 的模型来验证了,比如,Qwen3-32B 的配置如下:
| Field | Value |
|---|---|
| 64 | |
| 151936 | |
| 5120 | |
| 25600 | |
| 128 | |
| 64 | |
| 8 |
根据上式,最终的参数量为
我们使用 Qwen3-32B 的 index.json 可以得到其真实的参数量为
与我们计算的结果一致(这里除以 2 的原因是其表示模型权重文件的总大小,以 bytes 为单位,一般模型都是 bfloat16, 大小为 2 个 bytes, 因此总参数量为总大小除以权重的精度)
MoE Model
MoE model 与 Dense model 不同的地方在于每一层的 FFN。以下假设每层均使用 MoE,不包含共享专家,且输入 embedding 与输出 head 不共享权重:
对于 MoE layer, 其关键代码为:
class Qwen3MoeSparseMoeBlock:
    def __init__(self, config):
        self.num_experts = config.num_experts
        self.top_k = config.num_experts_per_tok
        self.gate = nn.Linear(config.hidden_size, config.num_experts, bias=False)
        self.experts = nn.ModuleList([Qwen3MoeMLP(config, intermediate_size=config.moe_intermediate_size) for _ in range(self.num_experts)])
我们记 为总专家个数,即 num_experts, 记 为激活专家个数,即 num_experts_per_tok 或者 top_k,
首先 gate 的参数量为 , 接下来每个 expert 都是一个 Qwen3MLP, 因此 experts 总参数量为 . 这样 MoE layer 的总参数量为
在推理时,只有一部分专家,也就是 个专家会参与计算,此时激活参数量为
我们带入到 Qwen3MoeForCausalLM 中就得到:
模型总参数量为:
模型激活参数量为:
这里的 对应每个专家的 moe_intermediate_size。激活参数量按“共享模块 + 被选中的专家”统计;embedding 查表不会执行整张表的矩阵乘法,因此不能直接用该数值精确计算 FLOPs。
MoE Verification
我们用 Qwen3-235B-A22B 的配置 来验证:
| Field | Value |
|---|---|
| 94 | |
| 151936 | |
| 4096 | |
| 1536 | |
| 128 | |
| 64 | |
| 4 | |
| 128 | |
| 8 |
计算得到总参数量为
计算得到激活参数量为
实际总参数量为
可以看到,计算结果与实际相符。
Extension
通过以上计算过程,我们可以很轻松将上述公式扩展到混合架构或者是 MLA 上,对于混合架构,我们分别计算不同 attention 的 layer 个数,然后分别计算。对于 MLA, 我们可以替换 Attention 的计算逻辑。
对于小语言模型系列,比如 0.6B 和 1.7B, 模型的大部分参数集中在 embedding 上,因此 Qwen3 采取了 tie embedding 的方式来减少参数量,具体做法就是 nn.Embedding 和 lm_head 共享参数。
Visualization
接下来,我们来可视化一下不同大小模型不同模块的参数量占比。计算的代码如下:
def compute_param_distribution( L: int, V: int, d: int, d_ff: int, d_h: int, h: int, h_kv: int, tie_word_embeddings: bool) -> dict:
    """
    Compute parameter distribution across different components of the model.

    Args:
        L: Number of layers
        V: Vocabulary size
        d: Hidden dimension
        d_ff: Feed-forward dimension
        d_h: Head dimension
        h: Number of attention heads
        h_kv: Number of key/value heads
        tie_word_embeddings: Whether input and output embeddings are tied

    Returns:
        dict: Parameter counts for each component
    """
    # Embedding parameters
    embedding = V * d
    if not tie_word_embeddings:
        embedding *= 2

    # Attention parameters per layer
    attention_per_layer = h * d_h * d + 2 * h_kv * d_h * d + d * h * d_h + 2 * d_h
    attention_total = attention_per_layer * L

    # FFN parameters per layer
    ffn_per_layer = 3 * d * d_ff
    ffn_total = ffn_per_layer * L

    # Two block RMSNorms; QK-Norm is already included in Attention.
    others = L * (2 * d) + d

    return {
        "Embedding": embedding,
        "Attention": attention_total,
        "FFN": ffn_total,
        "Others": others,
    }
对于 dense 模型,每部分的参数量可视化如下。以下保留原文图表;原代码对归一化参数的重复计数已在上方修正,精确数值以修正后的代码为准。
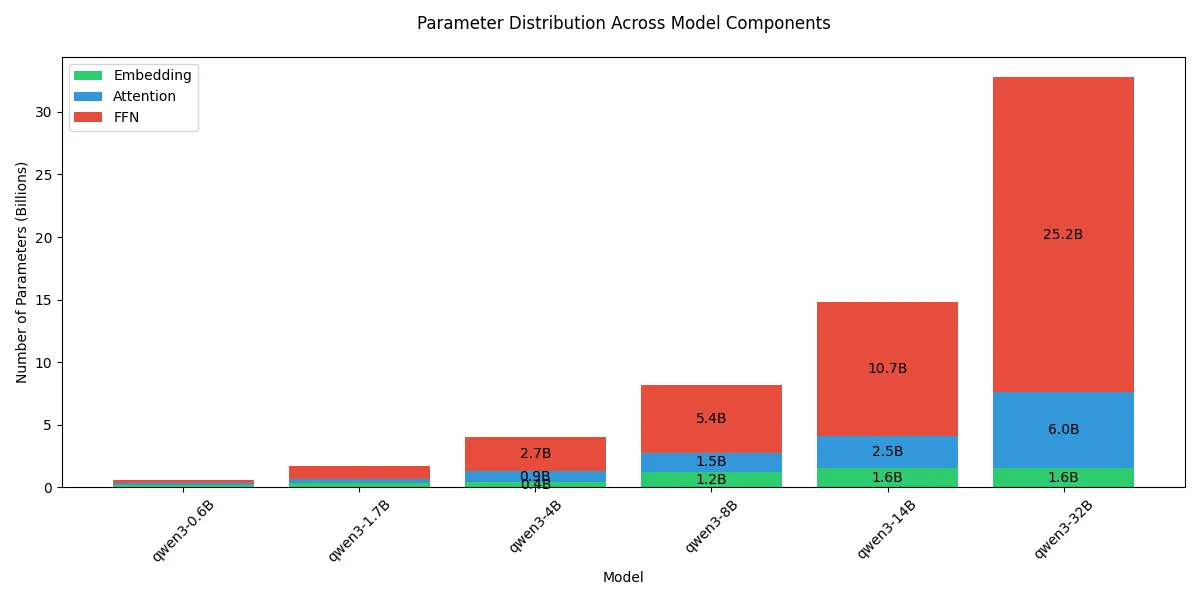
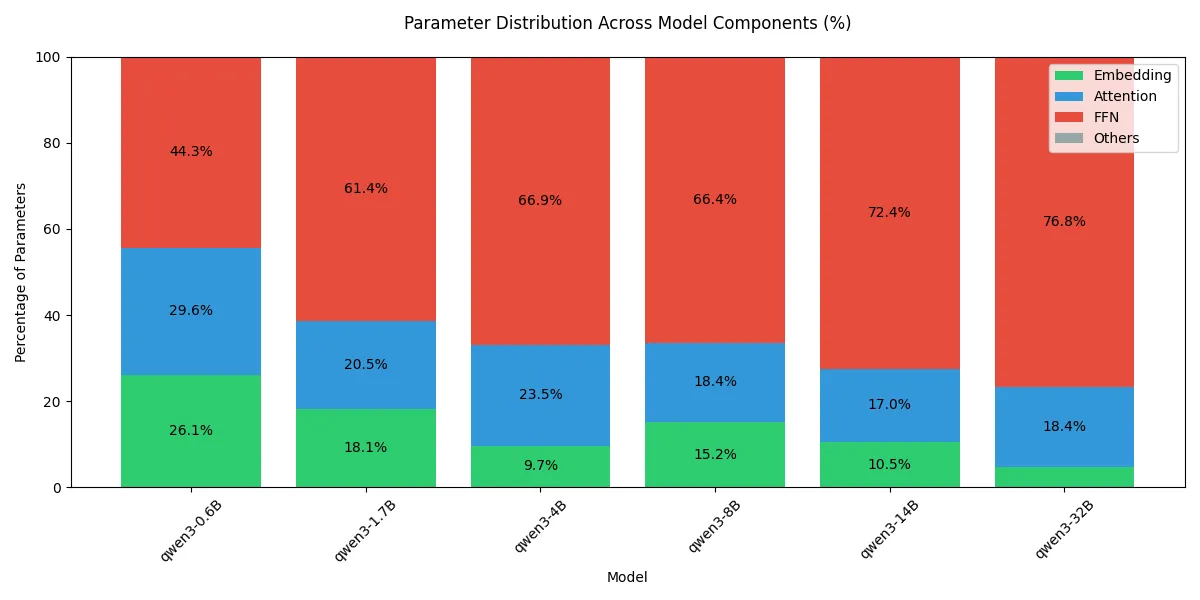
可以看到,随着模型 size 增加,模型大部分参数量都集中在 FFN 上。
接下来,我们可视化一下 MoE 模型的参数分布,核心计算代码如下:
def compute_moe_param_distribution(L, V, d, d_ff, d_h, h, h_kv, E, k, activate=False) -> dict:
    """
    Compute parameter distribution across different components of the MoE model.

    Args:
        L: Number of layers
        V: Vocabulary size
        d: Hidden dimension
        d_ff: Feed-forward dimension
        d_h: Head dimension
        h: Number of attention heads
        h_kv: Number of key/value heads
        E: Number of experts
        k: Number of experts per token
        activate: Whether to compute activated parameters

    Returns:
        dict: Parameter counts for each component
    """
    # Embedding parameters
    embedding = 2 * V * d

    # Attention parameters per layer
    attention_per_layer = h * d_h * d + 2 * h_kv * d_h * d + d * h * d_h + 2 * d_h
    attention_total = attention_per_layer * L

    # FFN parameters per layer
    if activate:
        moe_per_layer = E * d + 3 * k * d * d_ff
    else:
        moe_per_layer = E * d + 3 * E * d * d_ff
    ffn_total = moe_per_layer * L

    # Two block RMSNorms; QK-Norm is already included in Attention.
    others = L * (2 * d) + d

    return {
        "Embedding": embedding,
        "Attention": attention_total,
        "MoE": ffn_total,
        "Others": others,
    }
结果如下
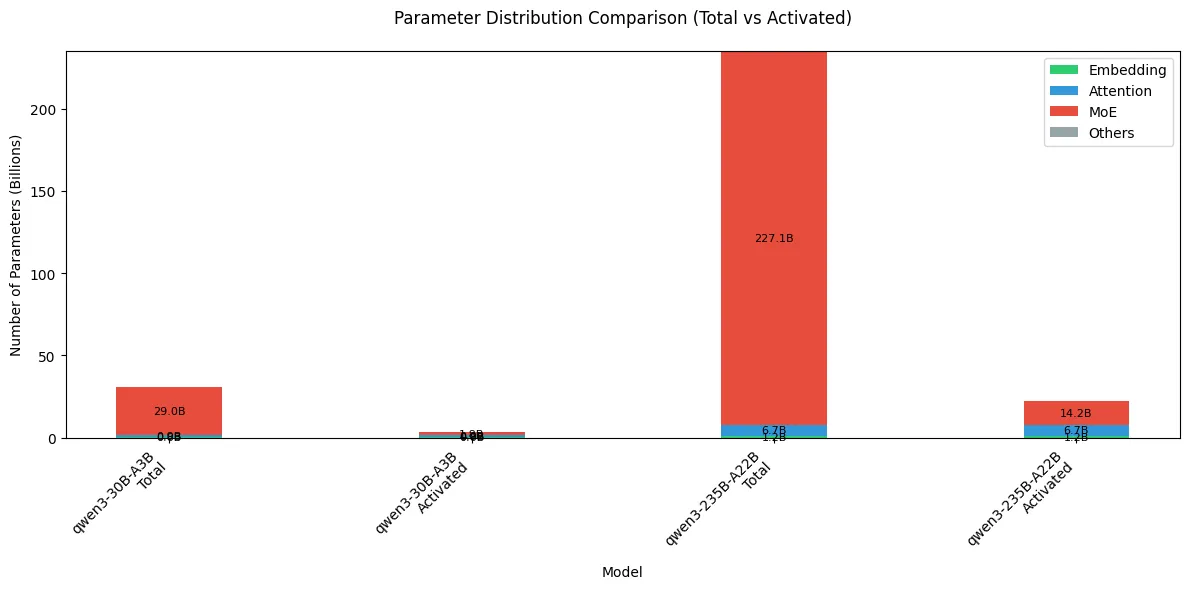
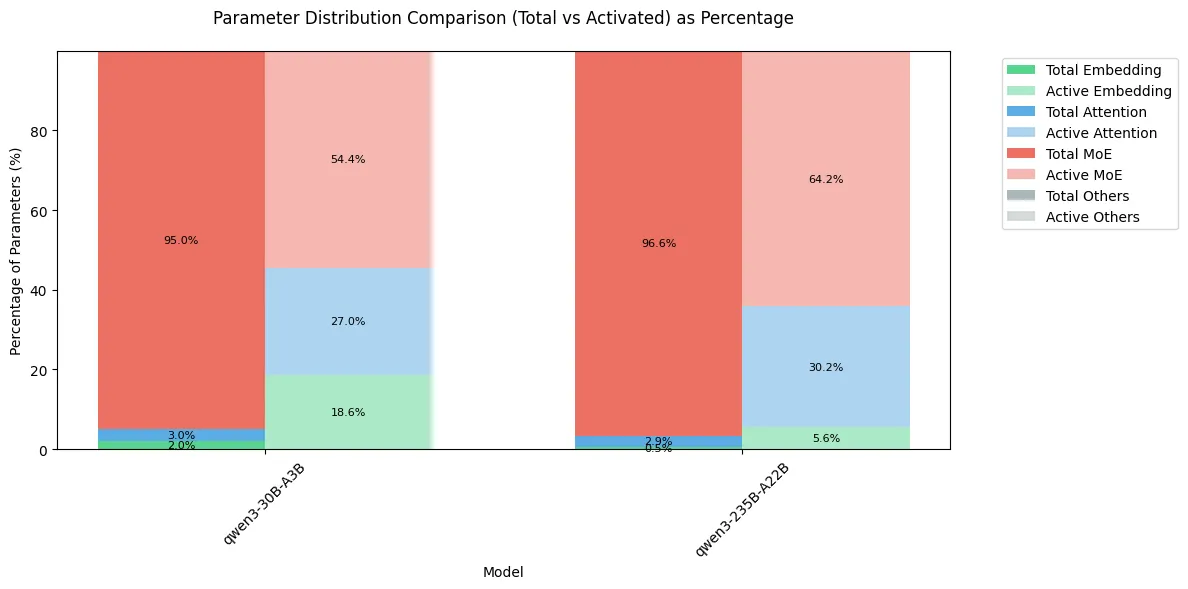
可以看到,MoE 模型的大部分参数还是集中在 MoE 模块上,但是由于其稀疏机制,在激活的参数里,MoE 占比从 95% 以上降低到了 60% 左右。
FLOPs 计算
基本规则与假设
对 、,计算 的主导 FLOPs 为 。额外的 bias 加法只有 次,通常可忽略。下面忽略 normalization、激活函数、residual、mask 和 softmax 的低阶开销,embedding 按查表处理。
算力也可用 PF-days 表示: FLOPs。下面先计算单条长度为 的序列,再扩展到完整训练集。
前向传播
模型包含输入 embedding、 层 decoder block 和输出 lm head:
Embedding 与输出 head
输入 embedding 查表不执行矩阵乘法,按本节口径计为 0 FLOPs。输出 head 将 的隐藏状态投影到词表:
共享输入与输出 embedding 可以减少参数存储,但不会省掉输出 head 的这次计算。
Attention:MHA、GQA 与 MQA
每层 Q、K、V、O 投影的总计算量为
其中 Q 和 O 各贡献 ,K 和 V 各贡献 。对每个 Query head, 和 attention probability 与 V 相乘各需要 FLOPs,因此
这里按完整 attention 矩阵计数;causal kernel 若跳过上三角,attention 核心计算的常数会降低。
- MHA:。进一步令 ,得到 。
- GQA:多个 Query head 共享一组 K/V,减少 K/V 投影和 KV cache,attention 核心仍按 个 Query head 计算。
- MQA:。
若用 表示每组共享 K/V 的 Query head 数,则 对应 MHA, 对应 MQA。
Dense FFN 与 MoE
两层 ReLU FFN 包含两个矩阵乘法,因此
SwiGLU FFN 使用三个投影:,其中 ,因此
对于包含 个专家、每个 token 激活 个专家的 MoE,router 是一个 的线性层。忽略路由选择和通信开销后:
这里 为单个专家的中间维度。总专家数影响模型存储,实际参与矩阵乘法的专家数决定主要 FLOPs。更多架构背景见 MoE。
前向汇总
对 GQA + SwiGLU 的 Dense 模型,
若使用标准 MHA 且 ,则
normalization 的开销为 ,相对于投影的 是低阶项;这里统一省略,不再混用精确计数与近似计数。
反向传播与训练总量
对线性层 ,反向传播需要计算输入梯度与权重梯度:
这两次矩阵乘法分别与前向计算同阶,因此矩阵乘法主导、全部参数参与训练时,,从而
这一估计不包含 optimizer update、通信、activation checkpointing 的重计算或冻结参数带来的变化。
从逐层公式到 Scaling Law
在标准 MHA 下取 ,并忽略 normalization 与 embedding/head 的参数,上一节的公式给出
若 attention 的 项和输出 head 的开销也相对较小,则
训练集总共有 个 token 时,得到常用估算:
这也就是常写为 的公式;本文统一用 表示参数量,以免与层数混淆。它适合矩阵投影占主导的 Dense 模型,长上下文、较大的词表或 MoE 应优先使用逐层公式。MoE 可以按激活的矩阵参数估算,但总参数量不能直接代入。
FLOPs 分布实验
保留原文基于 Chinchilla scaling law Table A9 的配置分析,筛掉 kv_size * n_heads != d_model 的配置,词表大小为 32,000。本实验使用两矩阵 FFN,与前面默认的三矩阵 SwiGLU 区分。计算所有层的代码为:
def compute_flops(L, V, d, d_ff, s, swiglu=False):
    lm_head_flops = 2 * V * d * s
    attention_flops = L * (8 * s * d * d + 4 * s * s * d)
    feed_forward_flops = L * (6 if swiglu else 4) * s * d * d_ff
    return lm_head_flops, attention_flops, feed_forward_flops
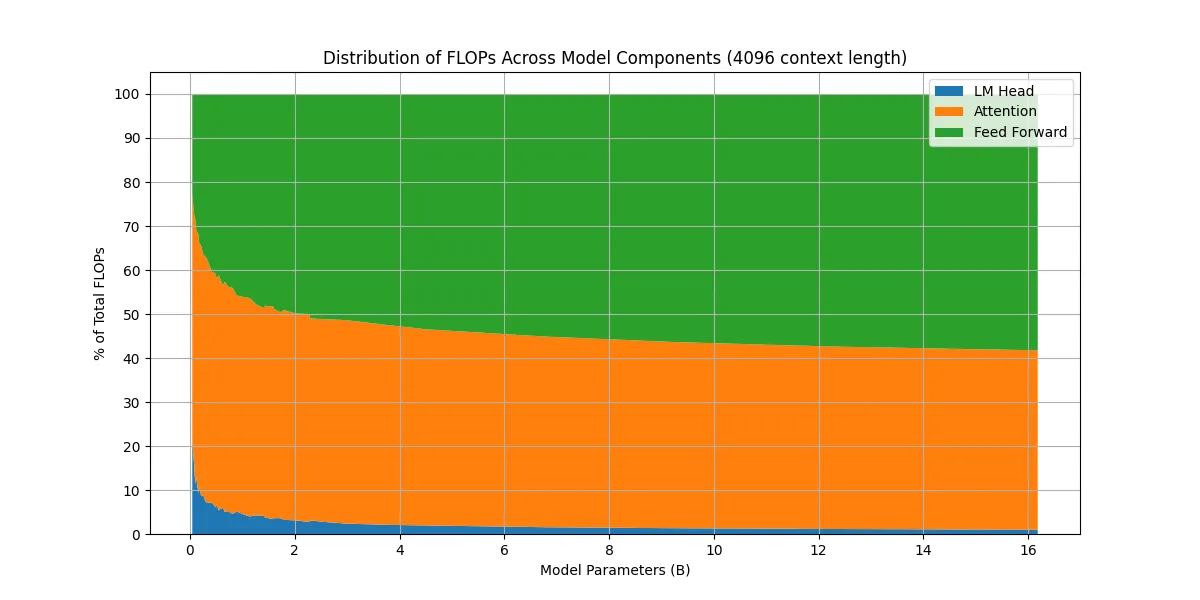
原文图表展示了模型规模增加时 FFN 计算占比的变化。原示例代码遗漏了层数乘数,上方代码已修正;图表保留供趋势参考,精确比例应以修正后的代码重算。
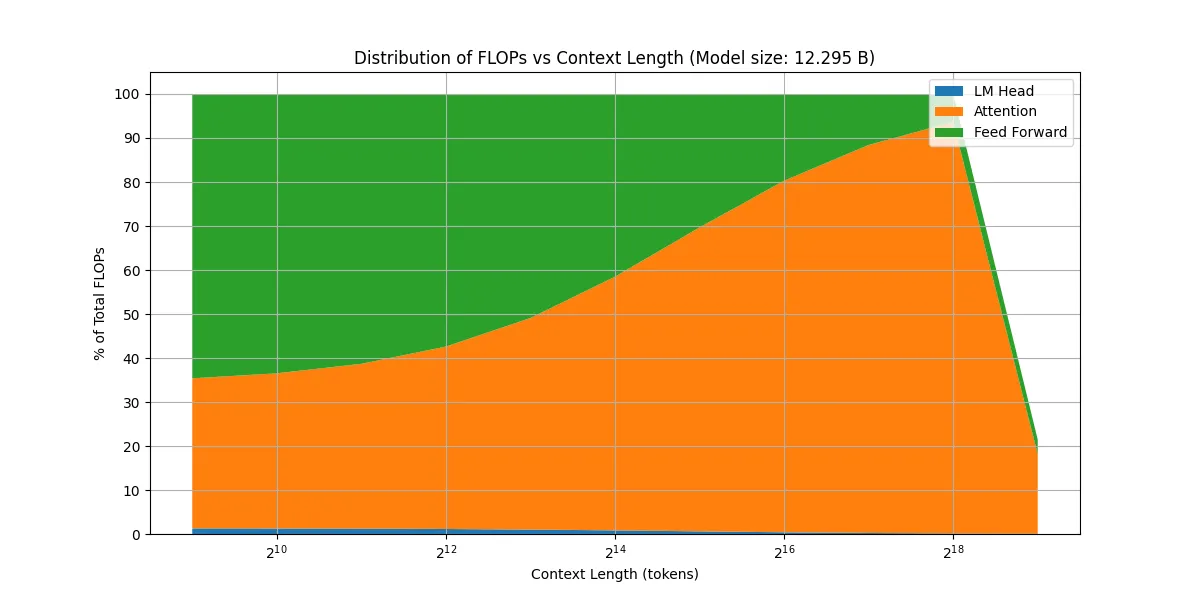
上下文变长时,attention 的二次项占比增加。原图最右侧的异常下降应视为数值或绘图异常,不能解释为真实计算量下降。
训练显存计算
训练显存可分为权重、优化器状态、梯度和激活值。下面先用权重、梯度、Adam 两个状态均为 BF16 的简化基线说明;若保留 FP32 主权重与 FP32 Adam 状态,静态部分由 变为 ,见后面的混合精度对照。
其中参数和梯度和优化器状态三部分是静态部分,在训练中始终存在,而 activation 则随训练不同阶段,数据格式动态变化
- Weights:
- Gradients(与权重同精度):
Optimizer States
AdamW 优化器需要维护两个动量状态:
- 一阶动量 :
- 二阶动量 :
- 合计:
AdamW 参考 的更新规则如下:
Activation
激活值是前向传播过程中计算得到的中间结果,用于在反向传播时计算梯度。
我们仅针对 linear layer 进行推导:
可以看到,计算第 层关于 的梯度时需要其输入 ,因此训练时需保存每个模块对应的输入,也就是激活值 (activation)。
Activation — Attention
以标准 MHA()、未融合算子且不使用 checkpointing 为例,按下列保存策略估算激活;具体 autograd 实现可能保存不同张量:
- Q/K/V 投影:共享输入 →
- :Q, K 均需保存 →
- softmax 输入:
- weighted sum 输入:
- output projection 输入:
Attention 合计:
Activation — FFN & LayerNorm
FFN(用于估算的两矩阵 FFN,假设 ):
- 第一层输入:
- 激活函数输入:
- 第二层输入:
- 合计:
LayerNorm:保存输入 →
Activation — Output
Output 包含以下组成部分:
- FinalNorm 输入:
- lm_head 输入:
- Loss 输入:
合计:
Activation — Total
将上述估算汇总。这里的 来自两矩阵 FFN 的保存策略,不是所有 SwiGLU/GQA 模型的通用常数:
只有当 显著大于 ,且输出层开销也较小时,才能保留最后一行的二次项近似。
可以看到,未优化的情况下,。这里 主要由 attention 部分产生,后续 Flash Attention 就针对这一点进行了优化。
Total Training Memory
将上面的结果进行汇总:
可以看到,训练阶段的内存占用分为固定部分 () 和动态部分 (),长序列且未使用 memory-efficient attention 时,动态部分可能主要由 attention 矩阵占据。这里保存的是反向传播所需的激活,不是推理 KV cache。
Experiments
以下保留原文在 80GB 显卡上的估算与实验记录,参数量列以十亿(B)为单位。由于原记录没有完整列出优化器精度、算子实现和运行环境,这些数值只能作历史对照,不能视为所有 Qwen3 实现的最大 batch size:
| Model | predicted | actual | ||||
|---|---|---|---|---|---|---|
| Qwen3-0.6B | 0.6 | 28 | 16 | 512 | 68 | 34 |
| Qwen3-1.7B | 1.7 | 28 | 16 | 512 | 42 | 28 |
| Qwen3-4B | 4 | 36 | 32 | 512 | 16 | 12 |
| Qwen3-8B | 8.1 | 36 | 32 | 512 | 4 | 2 |
predicted 为原文估算值,actual 为原文实验值。模型的 FFN、GQA 配置、优化器精度及运行时额外开销都会改变结果,实际部署应重新测量。
Case Study
对 Qwen3-4B 和 Qwen3-8B 等模型,可在固定 、 后通过 memory snapshot 检查峰值来自哪些张量。操作方法参考 PyTorch 显存可视化与 Snapshot 数据分析。
推理显存计算
权重、激活与 KV cache
推理无需保存 optimizer states 和参数梯度,也不需要为反向传播保留所有层的激活,但仍需要当前层的临时张量和工作区:
临时显存随 batch size、prefill/decode 阶段、上下文长度与算子实现变化。原文使用的 只是特定设置下的粗略经验值,不作为通用公式。
KV Cache Mechanism
自回归生成中,历史 token 的 K/V 可复用。每步只需要计算当前 token 的投影并追加到缓存:
若每次都重新投影历史 token,生成 个 token 的 K/V 投影工作量随 增长;缓存后这部分降为 。当前 Query 仍需读取历史 K/V,所以 KV cache 不会将完整 attention 的总计算量降为线性。
KV Cache Memory
对于 条等长序列、 层 GQA,BF16/FP16 KV cache 占用为
两个 分别代表 K/V 两份张量和每个元素的 2 bytes。MHA 时令 ;MQA 时令 。若请求长度不同,可将 替换为实际缓存的 token 总数 。量化 KV cache 则应替换每元素字节数,并计入量化元数据。
实际占用还可能包含 page granularity、padding、fragmentation 等开销。该公式针对标准 K/V 存储,MLA 等压缩缓存架构需按实际缓存张量重算。
静态权重与动态上下文
由 可得 KV cache 与 BF16 权重占用相等时的长度:
因此,临界长度取决于参数量、层数、KV head 配置和并发数,不能只根据模型名称中的参数规模判断。更大的 batch 或更长的上下文会增加动态缓存;MoE 即使每步只激活部分专家,若所有专家常驻显存,权重仍按总参数量 计算。
资源优化与权衡
Overview
| 阶段 | 核心方法 | 典型技术 |
|---|---|---|
| Training | 显存与效率提升 | Activation Checkpointing, Mixed Precision Training, Flash Attention, ZeRO, Pipeline/Model/Data Parallelism |
| Inference | 长序列与速度优化 | KV Cache Optimization, Paged/Radix Attention, Faster Attention, Quantization |
Mixed Precision Training
计算量大的部分用低精度,计算量小的部分用高精度。低精度参与运算,高精度避免 Overflow/Underflow。
下表比较三种简化的状态存储方案。实际配置取决于优化器和训练框架,AMP 本身不唯一决定状态精度:
| 状态存储方案 | 全 BF16 基线 | 全 FP32 | BF16 + FP32 主权重/状态 |
|---|---|---|---|
| Weights | BF16 (2) | FP32 (4) | BF16 (2) |
| Master weights | - | - | FP32 (4) |
| Gradients | BF16 (2) | FP32 (4) | BF16 (2) |
| Adam m | BF16 (2) | FP32 (4) | FP32 (4) |
| Adam v | BF16 (2) | FP32 (4) | FP32 (4) |
| Static total (bytes/param) | 8 | 16 | 16 |
Remark:
- 此表假设梯度与计算权重同精度;若梯度用 FP32,第三列合计为 。
- 混合精度的收益主要来自低精度运算和激活存储;静态显存是否降低取决于是否保留主权重以及优化器状态精度。
ZeRO
ZeRO 将 optimizer states / gradients / weights 按不同 GPU 切片存储,根据阶段划分状态,并通过相应通信保持训练一致;ZeRO-3 还需按需聚合参数。这样每张卡只需维护自己负责的一部分,大幅降低单卡显存需求 参考。
ZeRO Stages:
- ZeRO-1:shard optimizer states
- ZeRO-2:shard optimizer states + gradients
- ZeRO-3:shard all
以上为理想的常驻状态估算。ZeRO-3 的参数聚合、通信 buffer 和临时张量仍会产生额外峰值。分片数指对应的数据并行组大小。
Model Parallelism
将模型切分到不同 GPU 上:PP (Pipeline Parallelism) 按层划分,TP (Tensor Parallelism) 切分层内张量,EP (Expert Parallelism) 分配不同专家。通信方式随切分方案而变。
理想均匀切分时,权重的单卡常驻占用约为
这只是权重项。梯度、优化器状态、激活、流水线中同时驻留的 micro-batch 和通信 buffer 应分别估算;EP 主要分片专家参数,不能将整个模型简单除以所有并行度的乘积。
Activation Checkpointing
在反向传播时,重新计算所需的输入,来达到以时间换空间的目的 参考
| 策略 | 保留的激活 | 额外计算 |
|---|---|---|
| 无 checkpointing | 反向传播需要的中间结果 | 无重计算 |
| Selective checkpointing | 按张量大小和重算成本选择 | 重算部分模块 |
| 按层 full checkpointing | 主要保留每层边界输入 | 重算对应层的前向传播 |
选择性重计算通常保留重算成本高的投影结果,重算显存开销较大但相对便宜的 attention 中间结果。更详细的策略见 Reducing Activation Recomputation in Large Transformer Models。
若每层保存一个 BF16 输入,边界张量本身约占 ,但峰值还包括重算单层所需的临时激活;分段策略不同,这个系数也会变化。重计算可降低显存,却增加 FLOPs,因此前面的 不包含这部分额外成本。
Flash Attention
FlashAttention 参考 通过将 Attention 的计算进行分块,来提高内存访问效率以及降低反向传播时所需要的 activation 大小。
Flash Attention 通过 tiling 与 online-softmax 降低该部分显存并提升效率(详见 notes on Flash Attention)。这样 attention 部分的显存就由 降低到了 。
FlashAttention 仍计算精确 attention;固定 head 配置时,计算复杂度保持为 ,但无需显式存储完整 attention 矩阵,中间显存对序列长度呈线性增长。它优化的是访存和中间存储,不会消除 attention 的二次计算项。
KV Cache Optimization
针对公式中各因子的优化方向 参考:
- : KV cache compression, eviction, selection
- (bytes): KV cache quantization
- 缓存表示: key-value sharing, MLA 参考
- : MQA 参考, GQA 参考, MLA
Weight Quantization
使用低精度来表示高精度数值的方法,来减少内存占用/提高计算效率。
Offloading
将一部分参数/优化器状态/激活值等存储到 CPU 上,需要的时候再加载到 GPU 上。
| Offloading 场景 | 代表性工作 |
|---|---|
| 训练阶段 Offloading | ZeRO-Offload 参考 / ZeRO-Infinity, FSDP 参考 CPU Offload |
| 推理阶段 Offloading | FlexGen 参考, vLLM 参考 KV Cache Offload |
| MoE Offloading | KTransformers 参考, DeepSpeed-MoE 参考 |
框架实践
Training Frameworks
| Framework | Memory Optimizations |
|---|---|
| Megatron-LM 参考 | TP, SP, Activation Checkpointing |
| DeepSpeed 参考 | ZeRO-1/2/3, CPU/NVMe Offload, Activation Checkpointing |
| FSDP 参考 | Full parameter sharding, Gradient sharding, CPU Offload |
| Colossal-AI 参考 | ZeRO, TP, PP, Activation Checkpointing |
Inference Frameworks
| Framework | Key Techniques | Memory Optimizations |
|---|---|---|
| vLLM 参考 | Paged Attention | KV cache paging, Continuous batching |
| SGLang 参考 | Radix Attention | KV cache reuse, Efficient scheduling |
| TensorRT-LLM 参考 | Kernel fusion | Weight quantization, KV cache optimization |
选择框架后,先用上述公式给出资源量级,再测量实际峰值显存和吞吐。比较时保持模型、精度、序列长度、batch size、并行配置与 attention 实现一致。
总结
| 指标 | 主要估算 | 使用条件 |
|---|---|---|
| Dense 参数量 | Qwen3 风格,未共享 embedding | |
| MoE 参数量 | 将 替换为 | 每层均为 MoE,无共享专家 |
| MoE 激活参数量 | 将专家项中的 替换为 ,router 仍为 | 按共享参数与选中专家计数 |
| Dense 训练 FLOPs | 投影占主导,不含重计算和通信 | |
| 训练静态显存 | / | 全 BF16 基线 / 本文混合精度方案 |
| 训练激活显存 | 显式存储 attention 矩阵,固定 FFN 比例 | |
| 推理显存 | BF16 权重与标准 KV cache |
参数量由模型结构决定,FLOPs 还取决于参与计算的 token 与专家,显存进一步取决于状态精度、缓存策略和并行方案。优化时先定位占用来源:权重可量化或分片,训练激活可通过 checkpointing 与 FlashAttention 降低,推理 KV cache 可通过减少 KV heads、压缩或分页管理优化。节省显存可能增加计算或通信,应结合实际吞吐一起评估。
- DeepSeek-AI, “DeepSeek-V3 Technical Report,” arXiv:2412.19437, 2025.
- Mohammad Shoeybi et al., “Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism,” arXiv:1909.08053, 2020.
- Vijay Korthikanti et al., “Reducing Activation Recomputation in Large Transformer Models,” arXiv:2205.05198, 2022.
- Tri Dao et al., “FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness,” arXiv:2205.14135, 2022.
- Haoyang Li et al., “A Survey on Large Language Model Acceleration based on KV Cache Management,” arXiv:2412.19442, 2025.
- DeepSeek-AI, “DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model,” arXiv:2405.04434, 2024.
- Noam Shazeer, “Fast Transformer Decoding: One Write-Head is All You Need,” arXiv:1911.02150, 2019.
- Joshua Ainslie et al., “GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints,” arXiv:2305.13245, 2023.
- Elias Frantar et al., “GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers,” arXiv:2210.17323, 2023.
- Ji Lin et al., “AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration,” arXiv:2306.00978, 2024.
- Guangxuan Xiao et al., “SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models,” arXiv:2211.10438, 2024.
- Georgi Gerganov, “ggml: Tensor library for machine learning,” GitHub, 2023.
- Zechun Liu et al., “LLM-QAT: Data-Free Quantization Aware Training for Large Language Models,” arXiv:2305.17888, 2023.
- Jeonghoon Kim et al., “Memory-Efficient Fine-Tuning of Compressed Large Language Models via sub-4-bit Integer Quantization,” arXiv:2305.14152, 2023.
- Jie Ren et al., “ZeRO-Offload: Democratizing Billion-Scale Model Training,” arXiv:2101.06840, 2021.
- Yanli Zhao et al., “PyTorch FSDP: Experiences on Scaling Fully Sharded Data Parallel,” arXiv:2304.11277, 2023.
- Ying Sheng et al., “FlexGen: High-Throughput Generative Inference of Large Language Models with a Single GPU,” arXiv:2303.06865, 2023.
- Woosuk Kwon et al., “Efficient Memory Management for Large Language Model Serving with PagedAttention,” SOSP, 2023.
- Hongtao Chen et al., “KTransformers: Unleashing the Full Potential of CPU/GPU Hybrid Inference for MoE Models,” SOSP, 2025.
- Samyam Rajbhandari et al., “DeepSpeed-MoE: Advancing Mixture-of-Experts Inference and Training to Power Next-Generation AI Scale,” arXiv:2201.05596, 2022.
- Jeff Rasley et al., “DeepSpeed: System Optimizations Enable Training Deep Learning Models with Over 100 Billion Parameters,” KDD, 2020.
- Shenggui Li et al., “Colossal-AI: A Unified Deep Learning System For Large-Scale Parallel Training,” ICPP, 2023.
- Lianmin Zheng et al., “SGLang: Efficient Execution of Structured Language Model Programs,” NeurIPS, 2024.
- NVIDIA Corporation, “TensorRT-LLM: A TensorRT Toolset for Optimizing LLM Inference,” GitHub, 2023.
- Qwen3 Collection.
- Jordan Hoffmann et al., Training Compute-Optimal Large Language Models, 2022.
- PyTorch Embedding.
- Adam Casson, Transformer FLOPs.
- Ilya Loshchilov and Frank Hutter, Decoupled Weight Decay Regularization, 2019.
- Samyam Rajbhandari et al., ZeRO: Memory Optimizations Toward Training Trillion Parameter Models, 2020.